
AIはAI研究を加速させており、それがAPIのプレイブックを変える
ある話題のエッセイは、AIがAI研究そのものを劇的に加速させていると主張している。LLM API上で開発する開発者にとってそれが何を意味するかを解説する。
エッセイが実際に主張していること
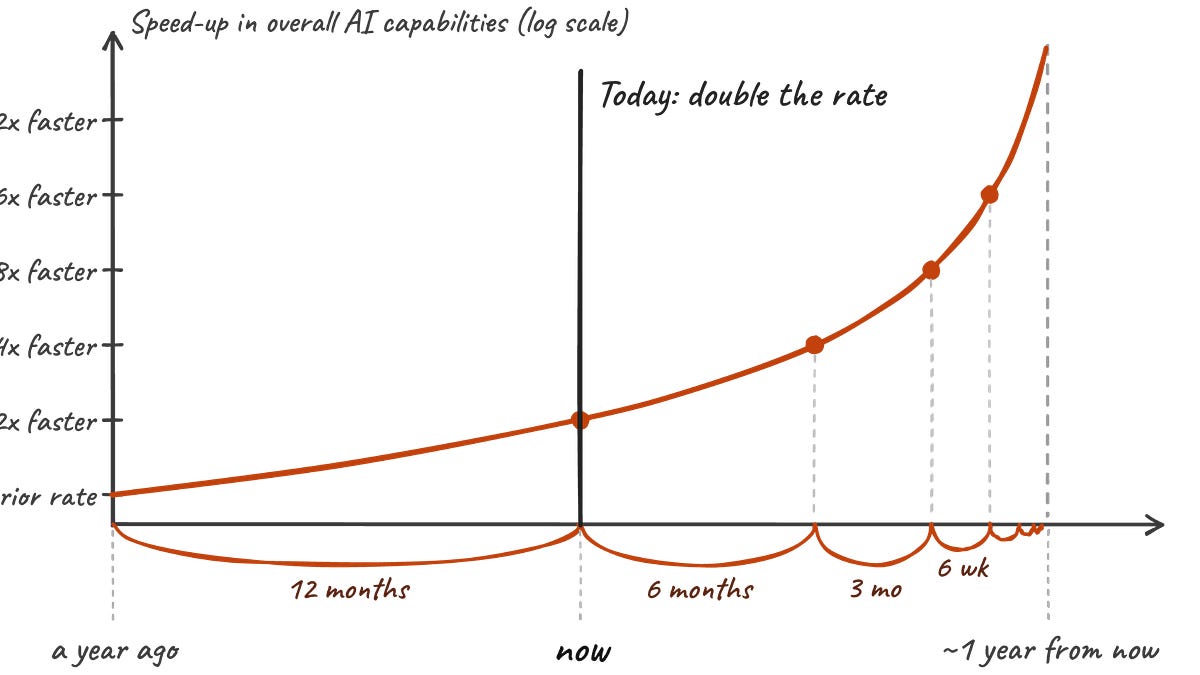
報じられているところによれば、エッセイの中心的な論点は、AIシステムが今や無視できない形でAI研究のペースに寄与しているというものだ。進歩を着実なものとして捉えるのではなく、より良いツールが次の改善サイクルをより速く生み出すのに役立つというフィードバックループを示唆している。
この記事はHacker Newsで大きな注目を集め、数百ポイントと長いコメントスレッドを蓄積した。この反応自体が一つのシグナルである。この主張は、読む人によって自明とも誇張とも受け取られる。
この主張の証明が難しい理由
加速は主張するのは簡単だが、測定するのは難しい。研究成果、モデルリリースの頻度、ベンチマークスコアはすべて、資金、ハードウェア供給、研究優先順位の変化など多くの理由で動く。加速を特にAI支援に帰属させるには慎重な対照が必要だが、提供された要約はそれを説明していない。
スレッドのコメント投稿者はまさにこの点を突いており、真の加速を通常のハイプサイクルからどう切り分けるのか疑問視しているようだ。この主張は確定した知見ではなく、報じられた論点として扱うべきだ。
LLM API上で構築するチームにとっての意味
モデル改善のペースが本当に圧縮されているなら、開発者にとっての実用的な帰結は、ハードコードされたあらゆる前提の寿命が短くなることだ。特定のモデルバージョンに合わせて調整したプロンプト、特定のコンテキストウィンドウに合わせたトークン予算、前四半期の挙動を前提に構築した評価スイートは、いずれもより速く古くなる。
ベンダー中立な対応は、モデルアクセスを薄い抽象化レイヤーの背後に置き、入力と出力をログに記録して新しいバージョンに対して評価を再実行できるようにし、プロンプトテンプレートをバージョン管理された成果物として扱うことだ。いずれも利用するプロバイダーに依存せず、モデルの差し替えが必要になったときにすべて報われる。
不確実性の下でのコストとレイテンシの計画
研究のペースが速まると、価格やレイテンシの変化が双方向に伴うことが多い。単一モデルのコストプロファイルをユニットエコノミクスにハードコードしているチームは、より安価または高速なティアが登場したとき、あるいは以前は安価だったモデルが非推奨になったときに、不意を突かれる可能性がある。
実用的な習慣は、タスクの難易度でルーティングすることだ。単純な分類や抽出の作業はより小さく安価なモデルに送り、推論の重いステップにはより大きなモデルを取っておく。このパターンはほとんどのモデルの入れ替わりに耐え、支出を単一ベンダーの現在のラインナップではなく実際のタスク需要に結びつける。
言説を批判的に読む
Hacker Newsのスレッドは、結論を得るためではなく反論を拾うためにざっと目を通す価値がある。懐疑的な読者は、加速の主張を反証するには何が必要かを問う傾向があり、これはモデル能力に関するあらゆるベンダー発表に対して持ち込むべき健全な問いだ。
エンジニアリングチームにとって有用な姿勢は、否定でも盲信的な採用でもない。自分の評価で何が変わるかに注目し、ベースラインを保ち、移行すべきかどうかは物語ではなく測定結果に決めさせることだ。