
L'IA accélère la recherche en IA, et cela change les règles du jeu des API
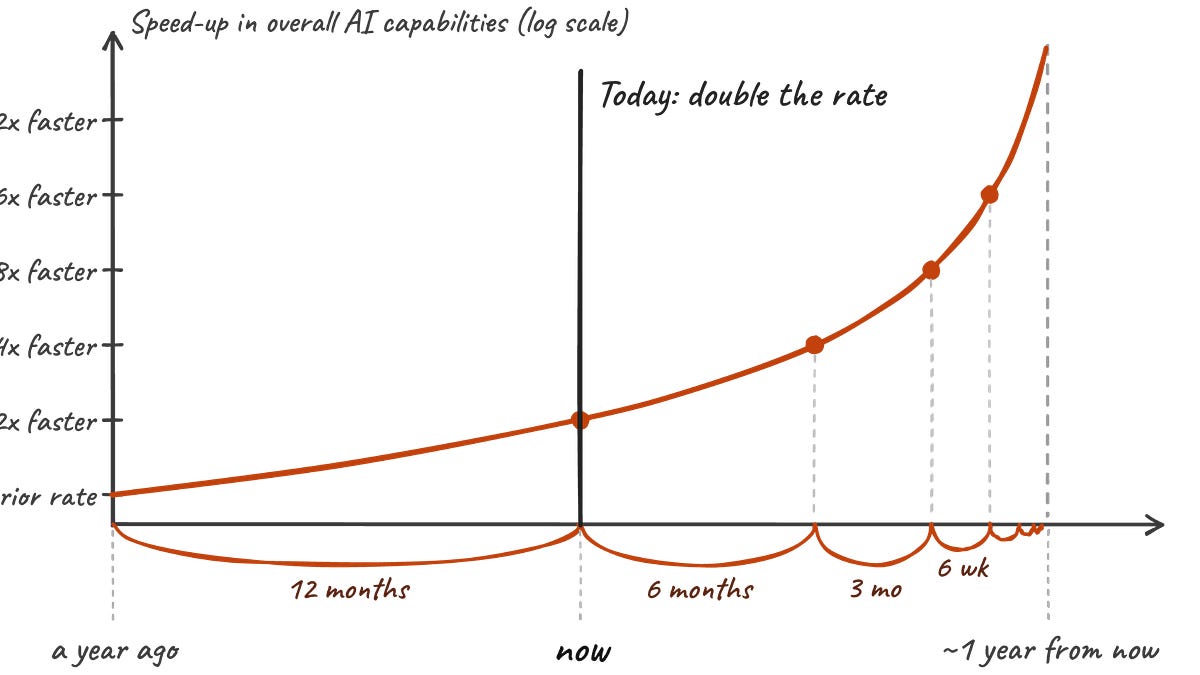
Un essai viral affirme que l'IA accélère considérablement la recherche en IA elle-même. Voici ce que cela signifie pour les développeurs qui s'appuient sur les API de LLM.
Ce que l'essai affirme réellement
L'argument central de l'essai, tel que rapporté, est que les systèmes d'IA contribuent désormais au rythme de la recherche en IA d'une manière difficile à ignorer. Plutôt que de présenter le progrès comme régulier, il suggère une boucle de rétroaction dans laquelle de meilleurs outils aident à produire plus rapidement la prochaine série d'améliorations.
L'article a suscité une attention considérable sur Hacker News, où il a accumulé des centaines de points et un long fil de commentaires. Cette réaction est en soi un signal : l'affirmation est perçue soit comme évidente, soit comme exagérée selon qui la lit.
Pourquoi l'affirmation est difficile à prouver
L'accélération est facile à affirmer et difficile à mesurer. La production de recherche, la cadence de publication des modèles et les scores aux benchmarks évoluent pour de nombreuses raisons, notamment le financement, l'approvisionnement en matériel et l'évolution des priorités de recherche. Attribuer une accélération spécifiquement à l'assistance par l'IA exige des contrôles rigoureux que le résumé fourni ne décrit pas.
Les commentateurs du fil semblent avoir insisté précisément sur ce point, en se demandant comment distinguer une véritable accélération du cycle habituel de battage médiatique. Considérez l'affirmation comme un argument rapporté plutôt que comme un résultat établi.
Ce que cela signifie pour les équipes qui s'appuient sur les API de LLM
Si le rythme d'amélioration des modèles se comprime réellement, la conséquence pratique pour les développeurs est une durée de vie plus courte de toute hypothèse codée en dur. Les prompts ajustés à une version spécifique d'un modèle, les budgets de tokens dimensionnés pour une fenêtre de contexte particulière et les suites d'évaluation construites autour du comportement du trimestre précédent vieillissent tous plus vite.
Une réponse indépendante des fournisseurs consiste à maintenir l'accès aux modèles derrière une fine couche d'abstraction, à journaliser les entrées et les sorties afin de pouvoir relancer les évaluations sur de nouvelles versions, et à traiter les modèles de prompts comme des artefacts versionnés. Rien de tout cela ne dépend du fournisseur que vous utilisez, et tout cela porte ses fruits lorsqu'un changement de modèle devient nécessaire.
Planification des coûts et de la latence dans l'incertitude
Une cadence de recherche plus rapide s'accompagne souvent de changements de tarification et de latence, dans les deux sens. Les équipes qui codent en dur le profil de coût d'un seul modèle dans leur économie unitaire peuvent être prises au dépourvu lorsqu'un palier moins cher ou plus rapide apparaît, ou lorsqu'un modèle auparavant bon marché est déprécié.
Une habitude pratique consiste à router selon la difficulté de la tâche : envoyer les travaux simples de classification et d'extraction vers des modèles plus petits et moins chers, et réserver les modèles plus grands aux étapes à forte intensité de raisonnement. Ce schéma résiste à la plupart des renouvellements de modèles et maintient les dépenses liées aux besoins réels des tâches plutôt qu'à la gamme actuelle d'un seul fournisseur.
Lire le débat avec esprit critique
Le fil Hacker News vaut la peine d'être parcouru non pas pour un verdict, mais pour les objections. Les lecteurs sceptiques ont tendance à demander ce qui pourrait réfuter l'affirmation d'accélération, une question saine à poser face à toute annonce d'un fournisseur sur les capacités d'un modèle.
Pour les équipes d'ingénierie, la posture utile n'est ni le rejet ni l'adoption par la foi. Observez ce qui change dans vos propres évaluations, conservez une référence de base, et laissez les résultats mesurés plutôt que le récit décider du moment de migrer.
FAQ
L'essai fournit-il des chiffres concrets sur l'accélération de la recherche ?
Dois-je changer de modèle à cause de cela ?
Pourquoi cet article a-t-il suscité autant d'attention ?
Références
Appelez ces modèles via une seule passerelle
Admesh fournit une API unifiée compatible OpenAI : une Base URL et une clé pour Claude, GPT, DeepSeek et plus encore. Les nouveaux comptes reçoivent un crédit d'essai sans expiration.