
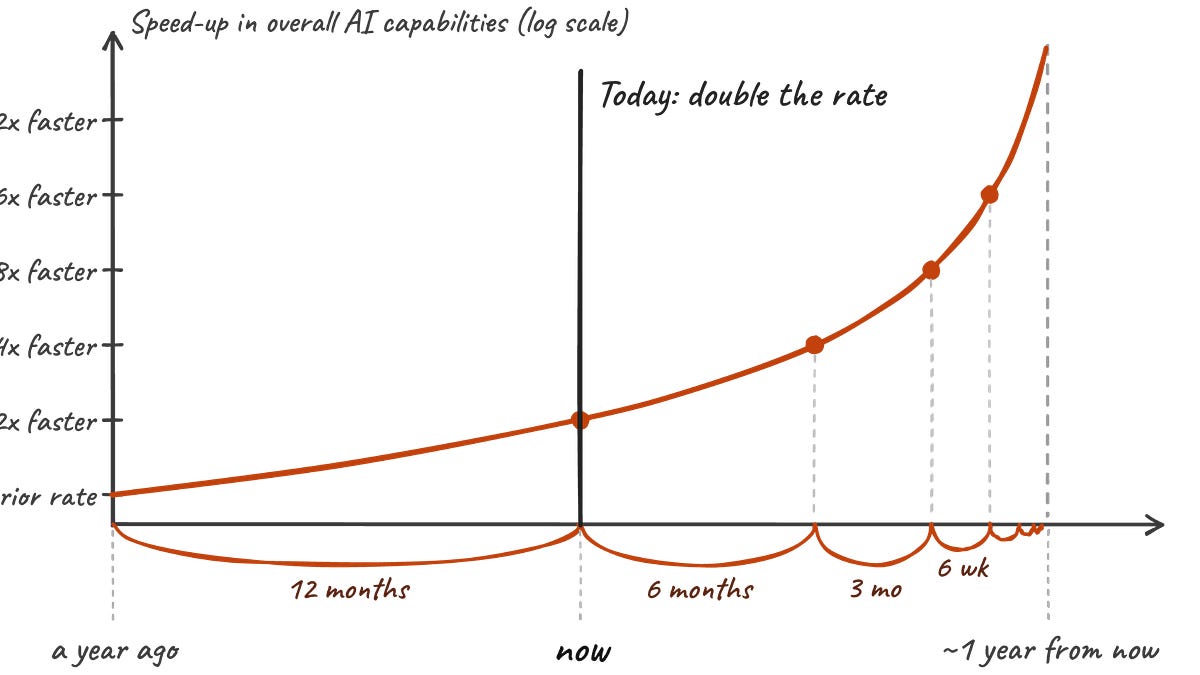
AI 正在加速 AI 研究,而这改变了 API 的玩法
一篇广为流传的文章认为,AI 正在大幅加速 AI 研究本身。以下是这对基于 LLM API 构建应用的开发者意味着什么。
这篇文章究竟主张了什么
据报道,这篇文章的核心论点是:AI 系统如今正在以难以忽视的方式推动 AI 研究的节奏。它并未将进展描述为平稳推进,而是暗示存在一个反馈循环:更好的工具帮助更快地产出下一轮改进。
这篇文章在 Hacker News 上引起了大量关注,积累了数百点和一条很长的评论串。这种反应本身就是一个信号:这一主张究竟是显而易见还是言过其实,取决于读者是谁。
为什么这一主张难以证明
加速很容易断言,却很难衡量。研究产出、模型发布节奏和基准测试分数都会因多种原因而变化,包括资金、硬件供应和研究重心的转移。要将加速具体归因于 AI 辅助,需要严谨的对照,而所提供的摘要并未描述这些。
该讨论串中的评论者似乎恰恰在这一点上提出了质疑,追问如何将真正的加速与惯常的炒作周期区分开来。请将这一主张视为一种被报道的观点,而非已有定论的发现。
这对基于 LLM API 构建应用的团队意味着什么
如果模型改进的节奏确实在压缩,那么对开发者而言的实际后果就是:任何硬编码的假设都会更快过时。针对特定模型版本调优的提示词、按特定上下文窗口设定的 token 预算,以及围绕上一季度行为构建的评估套件,都会更快失效。
一种不依赖特定供应商的应对方式是:将模型访问置于一层轻量抽象层之后,记录输入和输出以便针对新版本重新运行评估,并将提示词模板视为带版本号的产物。这些做法都不取决于你使用哪家供应商,而当模型更换变得必要时,它们都会带来回报。
不确定性下的成本与延迟规划
更快的研究节奏往往伴随着定价和延迟的变化,且可能朝任一方向变动。将单一模型的成本特征硬编码进单位经济模型的团队,可能会在出现更便宜或更快的档位时措手不及,或者在某个此前便宜的模型被弃用时陷入被动。
一个实用的习惯是按任务难度进行路由:将简单的分类和抽取工作交给更小、更便宜的模型,把更大的模型留给推理密集的步骤。这种模式能经受住大多数模型更替,并使支出与实际任务需求挂钩,而不是与单一供应商当前的模型阵容挂钩。
批判性地看待相关讨论
Hacker News 上的讨论串值得一读,不是为了得到一个结论,而是为了看其中的反对意见。持怀疑态度的读者往往会问:什么情况会证伪这一加速主张?对于任何关于模型能力的供应商公告来说,这都是一个有益的问题。
对工程团队而言,有用的姿态既不是全盘否定,也不是盲目采纳。关注你自己评估中的变化,保留一个基线,让实测结果而非叙事来决定何时迁移。