
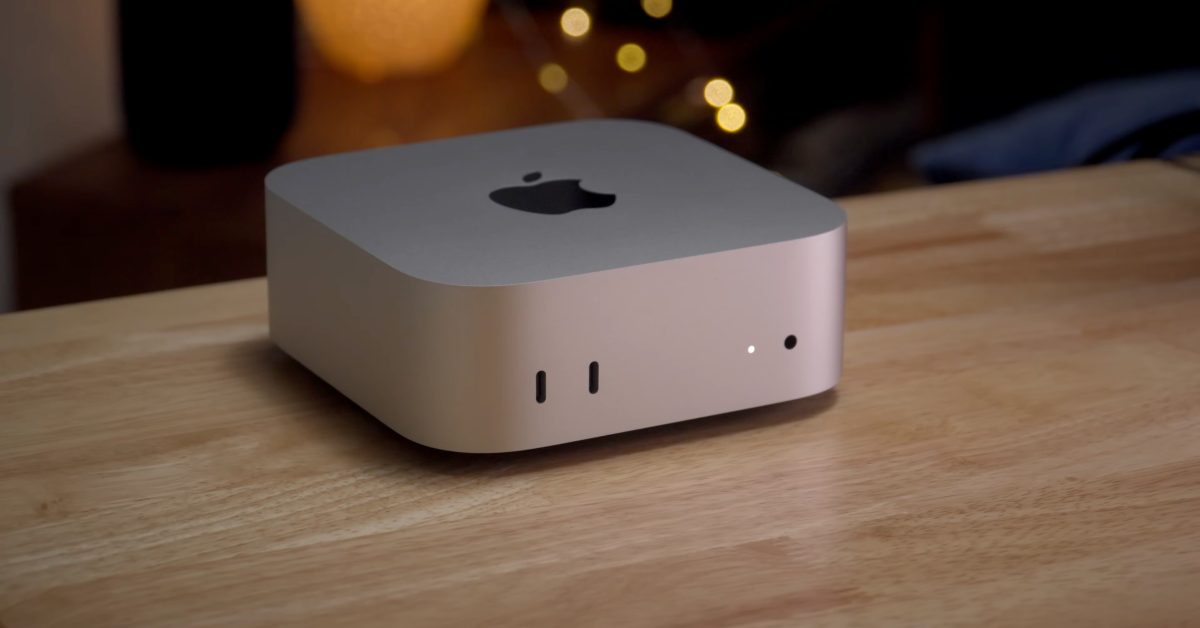
Apple prepararía una app para Mac que simplifica la ejecución de modelos de IA locales
Según los informes, Apple está desarrollando una app para Mac que facilita la ejecución de modelos de IA locales. Esto es lo que podría significar para los desarrolladores que eligen entre modelos locales y alojados
Qué dice realmente el informe
Según 9to5Mac, Apple tiene en marcha una nueva app para Mac que facilitaría la ejecución de modelos de IA localmente. El enfoque es deliberadamente sencillo: la propuesta es la comodidad, no el rendimiento bruto ni las herramientas de investigación.
Conviene ser precisos sobre lo que se sabe y lo que no. La fuente no confirma una fecha de lanzamiento, una lista de funciones, los formatos de modelo compatibles ni si la app será gratuita. Trata los detalles como reportados y no como establecidos, y espera que el panorama se aclare solo cuando Apple se pronuncie oficialmente.
El hilo de Hacker News vinculado a la noticia generó una respuesta considerable, lo que es una señal útil en sí misma: la inferencia local en la Mac es un tema que ya importa a los desarrolladores.
Por qué importa la inferencia local en Mac
Apple silicon cambió la economía de la inferencia local. La memoria unificada permite que un portátil aloje pesos de modelo que de otro modo requerirían una GPU dedicada con su propia VRAM, y el ecosistema de entornos de ejecución de la comunidad ha madurado en torno a ese hardware.
La fricción restante es sobre todo ergonómica. Descargar pesos, elegir una cuantización, configurar un servidor y gestionar ventanas de contexto sigue siendo una tarea engorrosa. Una app de primera parte que gestione esos pasos podría acercar los modelos locales a personas que nunca tocarían una línea de comandos.
Para los desarrolladores, eso importa menos como reemplazo de las API alojadas y más como una segunda opción en el conjunto de herramientas, en particular para trabajos sensibles a la privacidad y escenarios sin conexión.
Dónde encajan los modelos locales en una arquitectura basada en API
Hoy la mayoría de las aplicaciones de LLM en producción se construyen sobre API alojadas, y por buenas razones: sin aprovisionamiento de hardware, escalado predecible y acceso a modelos de frontera que no caben en un portátil. Una app local pulida no cambia esos fundamentos.
Lo que sí puede cambiar es la opción predeterminada para ciertas tareas. La redacción, la clasificación, la generación de embeddings sobre documentos privados y la creación rápida de prototipos son cargas de trabajo en las que un modelo local puede ser suficientemente bueno y notablemente más barato en el margen.
La conclusión práctica es arquitectónica: mantén tu capa de modelo abstraída detrás de una interfaz para que un entorno de ejecución local y un endpoint alojado sean intercambiables. Los equipos que codifican un único proveedor suelen arrepentirse cuando cambian los requisitos.
Qué hay que vigilar
Las preguntas interesantes son sobre la apertura. ¿Expondrá la app un endpoint local compatible con OpenAI al que puedan apuntar los SDK existentes? ¿Admitirá formatos de modelo de la comunidad o solo los seleccionados por Apple? ¿Habrá una API documentada para el control programático?
Si la respuesta a esas preguntas es sí, la app se convierte en una cómoda interfaz para un servidor de inferencia local en lugar de un jardín cerrado, y ese es el resultado que los desarrolladores deberían desear. Si es una experiencia cerrada, su impacto en los flujos de trabajo de ingeniería reales será más limitado.
En cualquier caso, la tendencia es clara: la inferencia se está extendiendo entre dispositivos locales y endpoints remotos, y las aplicaciones necesitarán cada vez más enrutar entre ambos.
Una forma neutral respecto al proveedor de prepararse
Independientemente de lo que lance Apple, el consejo de ingeniería duradero es tratar los modelos como componentes intercambiables. Define un contrato interno ligero para chat, completado y embeddings, y luego implementa adaptadores para cada backend que admitas.
Ese patrón te permite comparar un modelo local con uno alojado en tu propio conjunto de evaluación, enrutar las solicitudes sensibles localmente y recurrir a una API alojada cuando la calidad o el rendimiento lo exijan. Las capas de agregación y las pasarelas multiproveedor existen precisamente para abaratar la operación de ese enrutamiento.
No te obsesiones con una sola app no lanzada. Construye la abstracción ahora y podrás adoptar lo que se lance sin reescribir nada.
Preguntas frecuentes
¿Está confirmada la app para Mac de Apple?
¿Reemplazará esto las API de LLM alojadas para los desarrolladores?
¿Cómo debería preparar mi base de código?
Referencias
Llama a estos modelos a través de un solo gateway
Admesh ofrece una API unificada compatible con OpenAI: una URL base y una clave para Claude, GPT, DeepSeek y más. Las cuentas nuevas reciben crédito de prueba que nunca caduca.