
La IA está acelerando la investigación en IA, y eso cambia el manual de las API
Un ensayo viral sostiene que la IA está acelerando drásticamente la propia investigación en IA. Esto es lo que significa para los desarrolladores que construyen sobre API de LLM.
Qué afirma realmente el ensayo
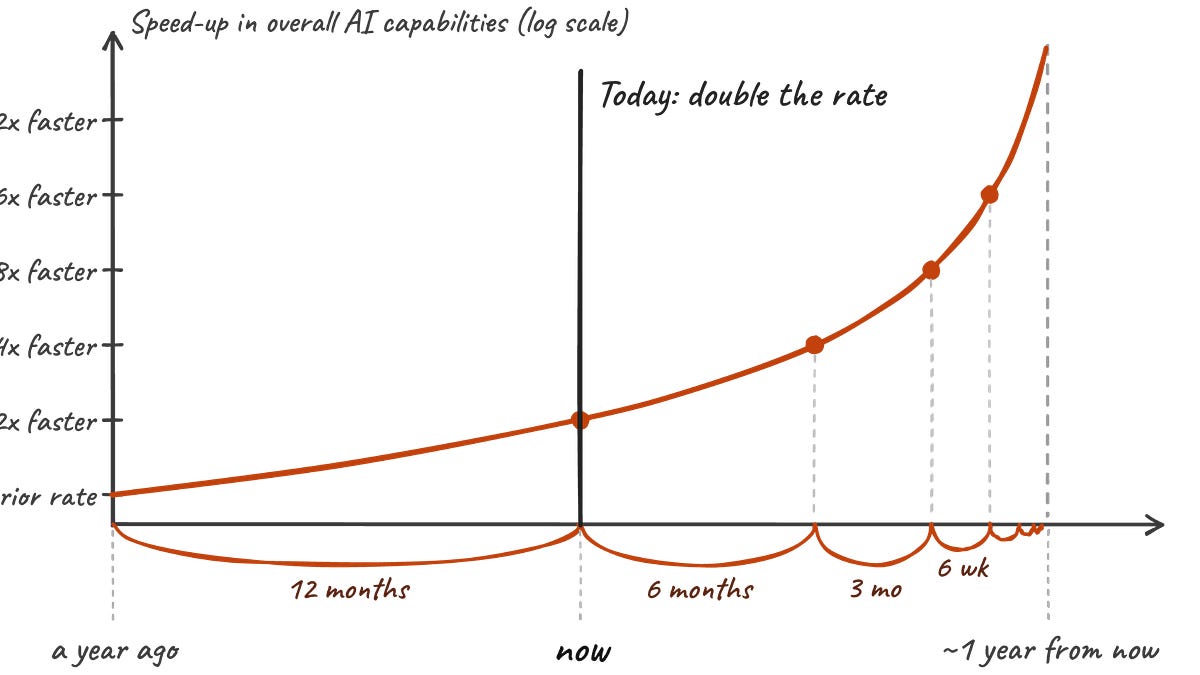
El argumento central del ensayo, según lo reportado, es que los sistemas de IA ahora contribuyen al ritmo de la investigación en IA de una manera difícil de ignorar. En lugar de enmarcar el progreso como constante, sugiere un bucle de retroalimentación en el que mejores herramientas ayudan a producir la siguiente ronda de mejoras más rápido.
La pieza atrajo una atención considerable en Hacker News, donde acumuló cientos de puntos y un largo hilo de comentarios. Esa reacción es en sí misma una señal: la afirmación se percibe como obvia o exagerada según quién la lea.
Por qué la afirmación es difícil de probar
La aceleración es fácil de afirmar y difícil de medir. La producción investigadora, la cadencia de lanzamiento de modelos y las puntuaciones de los benchmarks cambian por muchas razones, incluidos la financiación, el suministro de hardware y los cambios en las prioridades de investigación. Atribuir una aceleración específicamente a la asistencia de la IA requiere controles cuidadosos que el resumen proporcionado no describe.
Los comentaristas del hilo parecen haber insistido precisamente en este punto, cuestionando cómo se separa la aceleración genuina del ciclo habitual de hype. Conviene tratar la afirmación como un argumento reportado y no como un hallazgo establecido.
Qué significa para los equipos que construyen sobre API de LLM
Si el ritmo de mejora de los modelos realmente se está comprimiendo, la consecuencia práctica para los desarrolladores es que cualquier suposición codificada de forma rígida tiene una vida útil más corta. Los prompts ajustados a una versión específica de un modelo, los presupuestos de tokens dimensionados para una ventana de contexto concreta y las suites de evaluación construidas en torno al comportamiento del trimestre anterior envejecen más rápido.
Una respuesta neutral respecto al proveedor consiste en mantener el acceso a los modelos detrás de una capa de abstracción ligera, registrar las entradas y salidas para poder volver a ejecutar las evaluaciones contra nuevas versiones, y tratar las plantillas de prompts como artefactos versionados. Nada de eso depende del proveedor que se use, y todo ello compensa cuando un cambio de modelo se vuelve necesario.
Planificación de costes y latencia bajo incertidumbre
Una cadencia de investigación más rápida suele llegar junto con cambios de precios y latencia, en ambas direcciones. Los equipos que codifican de forma rígida el perfil de costes de un único modelo en su economía unitaria pueden verse sorprendidos cuando aparece un nivel más barato o más rápido, o cuando se retira un modelo que antes era barato.
Un hábito práctico es enrutar según la dificultad de la tarea: enviar el trabajo sencillo de clasificación y extracción a modelos más pequeños y baratos, y reservar los modelos más grandes para los pasos que requieren mucho razonamiento. Ese patrón sobrevive a la mayoría de los cambios de modelos y mantiene el gasto ligado a las necesidades reales de la tarea en lugar de a la línea de productos actual de un único proveedor.
Leer el discurso con criterio
Vale la pena hojear el hilo de Hacker News no en busca de un veredicto, sino de las objeciones. Los lectores escépticos suelen preguntar qué refutaría la afirmación de la aceleración, una pregunta saludable que conviene aplicar a cualquier anuncio de un proveedor sobre capacidades de modelos.
Para los equipos de ingeniería, la postura útil no es ni el descarte ni la adopción por fe. Observa qué cambia en tus propias evaluaciones, mantén una línea base y deja que los resultados medidos, y no la narrativa, decidan cuándo migrar.
Preguntas frecuentes
¿Aporta el ensayo cifras concretas sobre la aceleración de la investigación?
¿Debería cambiar de modelo por esto?
¿Por qué recibió tanta atención esta publicación?
Referencias
Llama a estos modelos a través de un solo gateway
Admesh ofrece una API unificada compatible con OpenAI: una URL base y una clave para Claude, GPT, DeepSeek y más. Las cuentas nuevas reciben crédito de prueba que nunca caduca.